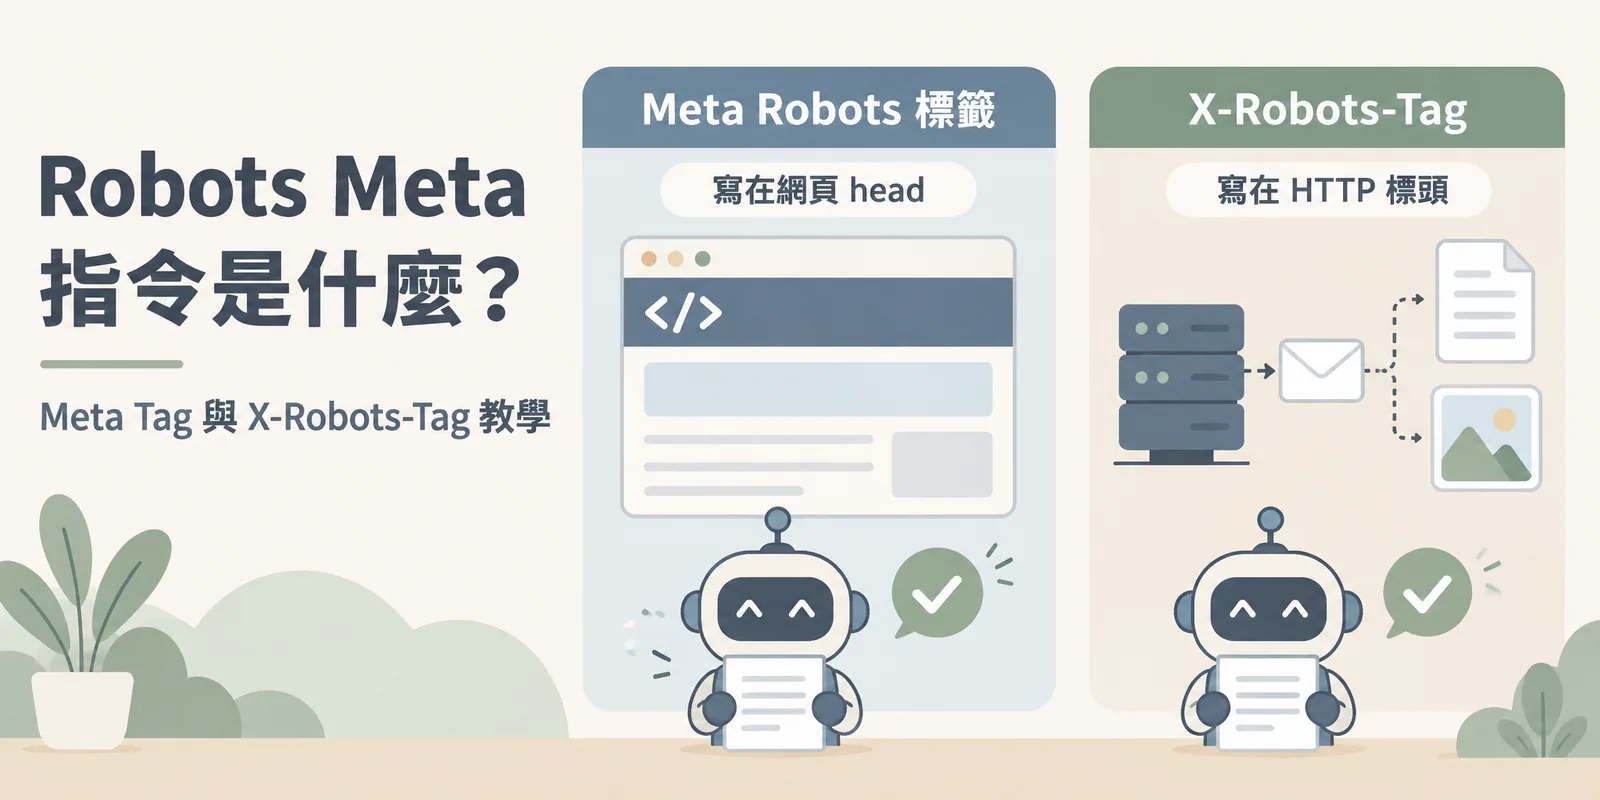
Robots Meta 指令(Robots Meta Directives)是寫在網頁 HTML <head> 或 HTTP 表頭中的程式語法,用來告訴 Google、Bing 等搜尋引擎爬蟲「這個頁面要不要被索引、連結要不要被追蹤」。它比 robots.txt 提供更精準的單頁控制能力,是 SEO 技術設定中不可或缺的一環。在 AI 搜尋時代,Google 的 AI 概覽與 AI Mode 也沿用這些指令,決定能否引用您的網頁;至於內容是否被拿去訓練 AI 模型,則主要由 robots.txt 對各家 AI 爬蟲的設定決定。本文將完整說明 Meta Robots Tag 與 X-Robots-Tag 的差別、10 個常用參數、使用情境與最佳實務,適合網站管理員、SEO 從業者、行銷人員與工程師閱讀。
什麼是 Robots Meta 指令?
Robots Meta 指令是由 Google、Bing 等搜尋引擎各自公布支援規則的頁面層級指令,放在網頁 HTML 的 <head> 區塊或伺服器 HTTP 表頭中,用來指示網路爬蟲(Crawler/Bot)如何處理該頁面。常見的指令包括是否索引(index/noindex)、是否追蹤連結(follow/nofollow)、是否顯示摘要(nosnippet)等。
Robots Meta 指令的核心目的,是讓網站擁有者能精準控制每個頁面在搜尋引擎中的呈現方式,而不必依賴 robots.txt 的整站規則。
為什麼需要 Robots Meta 指令?
即使您有 robots.txt 檔案管理整站的爬蟲行為,仍會遇到許多情況需要針對單一頁面做更細緻的設定。例如:後台登入頁、會員專屬頁、感謝頁、搜尋結果頁、過濾條件 URL、測試用頁面等,這些頁面您可能不希望出現在 Google 搜尋結果,但又需要讓爬蟲能追蹤頁面上的連結傳遞權重。
三個情境最能說明 Robots Meta 指令的價值:
robots.txt 控制整個目錄或網址模式,Robots Meta 指令則精準控制單一頁面,顆粒度更細。robots.txt 禁止爬取會讓 Google 連 noindex 標籤都看不到,Robots Meta 可以讓爬蟲讀取頁面、但不索引內容。Robots Meta 指令的兩種類型
Robots Meta 指令在實務上分為兩種傳遞方式,雖然兩者支援的參數(directives)幾乎完全相同,但傳遞位置與適用情境不同。理解兩者差異,才能在不同情境下選擇正確的方式。
| 類型 | 位置 | 適用檔案 | 主要用途 |
|---|---|---|---|
| Meta Robots Tag | HTML <head> 內 |
僅 HTML 頁面 | 單頁索引/追蹤控制 |
| X-Robots-Tag | HTTP Response Header | HTML + PDF + 圖片 + 影片等 | 非 HTML 檔案或整站規則 |
選擇哪一種?簡單判斷邏輯
- 標準 HTML 頁面 → 用 Meta Robots Tag:設定容易、容易檢查、CMS 通常內建支援(如 Yoast SEO、Rank Math 等 WordPress 外掛)。
- PDF / 圖片 / 影片 / 非 HTML 檔案 → 用 X-Robots-Tag:這些檔案無法寫 meta 標籤,只能透過伺服器表頭設定。
- 需要批次套用整個目錄或檔案類型 → 用 X-Robots-Tag:在
.htaccess或 Nginx 設定一次處理大量檔案。 - 無法修改 HTML 原始碼 → 用 X-Robots-Tag:例如使用第三方平台、產生器、或網頁是動態組裝出來的。
Meta Robots Tag 完整參數說明
以下整理目前仍受 Google 官方支援的 Robots Meta 指令參數。所有參數不區分大小寫,但建議統一使用小寫,維持程式碼一致性。注意有些參數可能只被部分搜尋引擎支援,或處理方式略有差異。
-
index(預設值)
告訴搜尋引擎可以索引此頁面。這是預設行為,實務上不需要特別寫出來。
<meta name="robots" content="index">等同於不加任何標籤。 -
noindex
告訴搜尋引擎不要索引此頁面,該頁面不會出現在搜尋結果中。最常用於後台、感謝頁、會員專屬頁。
電商感謝頁加
noindex避免被 Google 索引後造成轉換追蹤混亂。 -
follow(預設值)
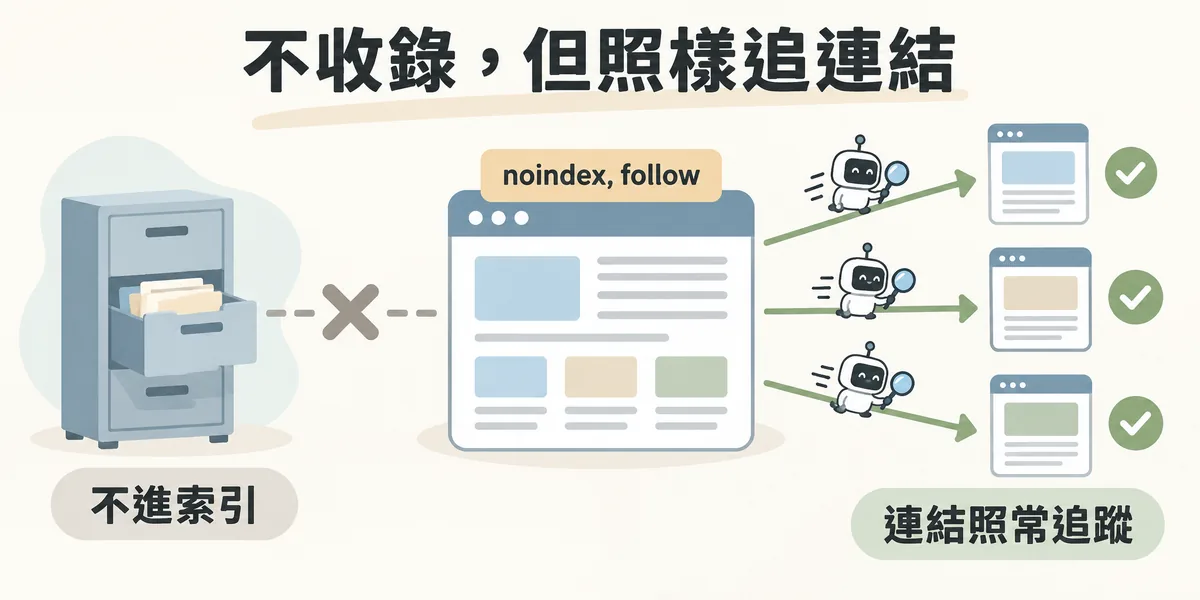
告訴爬蟲追蹤頁面上的所有連結,並將連結權重傳遞給目標頁面。即使頁面本身設定 noindex,只要搭配 follow,連結權重仍可傳遞。
<meta name="robots" content="noindex, follow">不索引但傳遞權重。 -
nofollow
告訴爬蟲不要追蹤頁面上的任何連結,也不傳遞連結權重。常用於使用者生成內容(UGC)區、留言區、廣告區等不可信任連結密集的頁面。
論壇留言區整頁加
nofollow避免 SEO 垃圾連結傳遞權重。 -
noimageindex
告訴爬蟲不要索引此頁面上的所有圖片,圖片不會出現在 Google Images 搜尋結果。適合付費圖庫、版權嚴格的攝影作品集。
攝影工作室作品頁加
noimageindex防止圖片被搜尋引擎抓取使用。 -
none
等同於同時使用
noindex, nofollow。實務上較少單獨使用,因為可讀性較差,建議改用noindex, nofollow較明確。<meta name="robots" content="none">=noindex, nofollow。 -
noarchive
原本用來告訴搜尋引擎不要在搜尋結果頁(SERP)顯示「頁庫存檔」連結。Google 已取消頁庫存檔功能,官方文件說明 Google 搜尋不再使用這個指令;其他搜尋引擎的處理方式,請以各自的官方文件為準。
既有程式碼中的
noarchive不會造成問題,但不要再期待它對 Google 搜尋產生作用。 -
nosnippet
告訴搜尋引擎不要在搜尋結果中顯示頁面的文字摘要與影片預覽。用於希望使用者必須點擊進站才能看到內容的場景。
新聞付費牆網站加
nosnippet避免 Google 直接顯示付費內容片段。 -
max-snippet:[number]
設定 Google 在搜尋結果中顯示的文字摘要最大字元數。
max-snippet:0等同 nosnippet、max-snippet:-1表示不限制。<meta name="robots" content="max-snippet:160">限制摘要最多 160 字元。 -
unavailable_after:[date]
告訴搜尋引擎在指定日期之後停止索引此頁面。日期格式建議使用 RFC 850 或 ISO 8601。適合限時活動頁、預售頁、即將下架的促銷頁。
<meta name="robots" content="unavailable_after: 2026-12-31T23:59:59+08:00">
noodp 與 noydir 原本用來阻止 Google 使用 DMOZ 或 Yahoo Directory 的描述作為搜尋摘要,但 DMOZ 已停站、Yahoo Directory 也早已停運,這兩個參數目前已完全無效,可從現有程式碼中移除。
Meta Robots Tag 實際語法與範例
Meta Robots Tag 寫在 HTML <head> 區塊內,基本語法結構非常簡單,但實務上有幾個變化形需要熟悉。
基本語法
<!DOCTYPE html>
<html>
<head>
    <meta name="robots" content="noindex, follow">
</head>
<body>
    ...
</body>
</html>
針對特定搜尋引擎設定
若想針對特定爬蟲(User Agent)下指令,可將 name="robots" 中的 robots 替換成爬蟲名稱。常見爬蟲名稱包括:googlebot(Google)、bingbot(Bing)、googlebot-news(Google News)、googlebot-image(Google 圖片)。
<!-- 對所有爬蟲生效 -->
<meta name="robots" content="noindex">

<!-- 只針對 Google 爬蟲生效 -->
<meta name="googlebot" content="noindex, follow">

<!-- 只針對 Bing 爬蟲生效 -->
<meta name="bingbot" content="noindex">

<!-- 不讓 Google News 收錄 -->
<meta name="googlebot-news" content="noindex">
合併多個指令
同一個 name 的多個參數可以用逗號分隔合併在一個標籤內,不需要寫多個 meta 標籤。但不同 user-agent 必須拆成不同 meta 標籤,不能合併。
<!-- OK 正確:同一 user-agent 多參數合併 -->
<meta name="robots" content="noindex, nofollow, noarchive, nosnippet">

<!-- OK 正確:不同 user-agent 分開寫 -->
<meta name="robots" content="follow">
<meta name="googlebot" content="noindex, follow">

<!-- NG 錯誤:不能把不同 user-agent 寫在同一標籤 -->
<meta name="robots, googlebot" content="noindex">
不同類型的頁面有不同的最佳設定。以下是台灣中小企業網站最常遇到的情境:
noindex, nofollow;感謝頁/確認頁 → noindex, follow;站內搜尋結果 → noindex, follow;標籤頁(若內容單薄)→ noindex, follow;產品頁/文章頁 → 不加標籤(預設 index, follow)。X-Robots-Tag 使用情境與設定
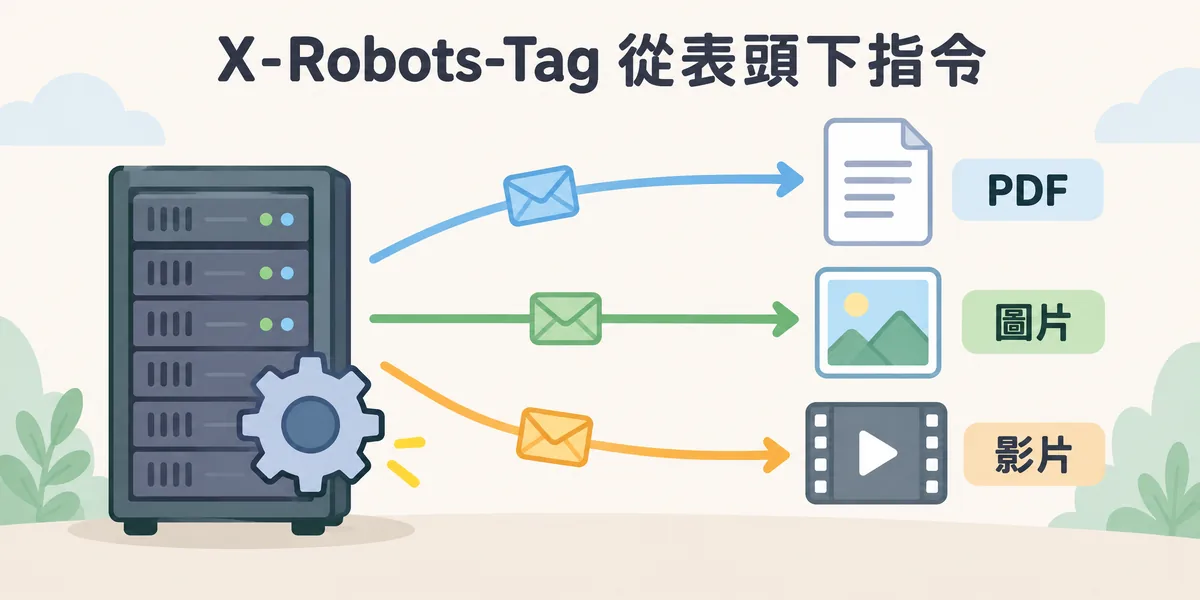
X-Robots-Tag 是透過 HTTP Response Header 傳遞 Robots 指令的方式,功能與 Meta Robots Tag 幾乎相同,但有三個 Meta Robots Tag 無法做到的能力:處理非 HTML 檔案、批次套用整個目錄、使用正則表達式比對。
四種典型使用情境
-
控制 PDF / 圖片 / 影片索引
這些檔案沒有
<head>區塊可寫 meta 標籤,只能用 X-Robots-Tag。例如不想讓內部文件 PDF 出現在 Google 搜尋。內部年度報告 PDF 設定X-Robots-Tag: noindex避免外洩到搜尋結果。 -
阻止特定元素被索引
針對網頁中的特定資源(例如圖片、影片)單獨設定,而不影響整個頁面。
攝影師作品網的圖片個別檔案加
noindex,但頁面本身仍能被索引導流。 -
無法修改 HTML 原始碼時
使用第三方平台、SaaS 或 HTML 由 JavaScript 動態組裝,無法輕易插入 meta 標籤,此時 X-Robots-Tag 是唯一解法。
SPA(單頁應用)頁面在伺服器層設定 X-Robots-Tag,避免依賴前端渲染。
-
大量檔案批次處理
一次套用到整個目錄或符合特定條件的所有檔案,不必逐一修改。
用
.htaccess的FilesMatch規則一次讓所有 .pdf 檔案加上 noindex。
在 Apache(.htaccess)設定範例
# 讓所有 PDF 檔案不被索引,但連結追蹤
<FilesMatch "\\.pdf$">
    Header set X-Robots-Tag "noindex, follow"
</FilesMatch>

# 讓特定目錄下的所有檔案不被索引
<Directory "/var/www/html/private">
    Header set X-Robots-Tag "noindex, nofollow"
</Directory>

# 讓所有 .doc 與 .docx 檔案不被索引
<FilesMatch "\\.(doc|docx)$">
    Header set X-Robots-Tag "noindex"
</FilesMatch>
在 Nginx 設定範例
# 在 server 或 location 區塊內設定
location ~* \\.(pdf|doc|docx)$ {
    add_header X-Robots-Tag "noindex, follow";
}

# 整個目錄禁止索引
location /private/ {
    add_header X-Robots-Tag "noindex, nofollow";
}
HTTP Response Header 實際呈現
設定完成後,可以用 Chrome DevTools(F12)→ Network 分頁,點選任一資源檢查 Response Headers,應該會看到類似以下回應:
HTTP/1.1 200 OK
Date: Fri, 22 May 2026 10:23:45 GMT
Content-Type: application/pdf
X-Robots-Tag: noindex, follow
Content-Length: 245678
...
curl -I https://example.com/file.pdf 指令查看 HTTP 表頭。Google Search Console 的「網址檢查工具」也會顯示偵測到的 X-Robots-Tag 內容。
Meta Robots vs Robots.txt vs Canonical 差異
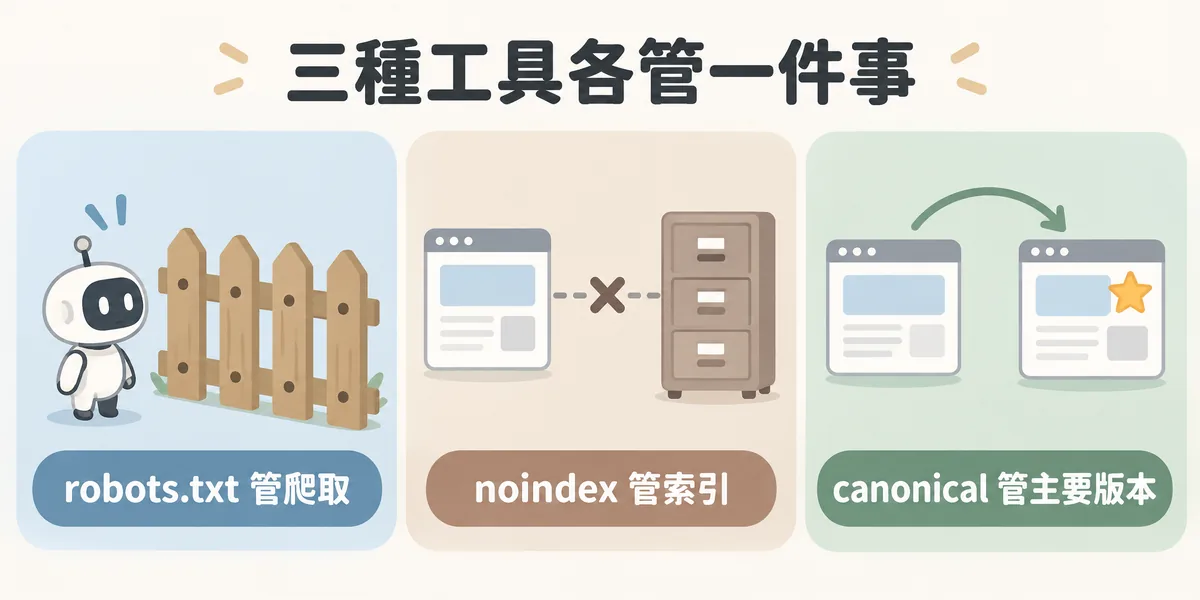
許多 SEO 新手會混淆 Robots Meta 指令、robots.txt、rel="canonical" 這三個技術設定。它們都與「搜尋引擎如何處理頁面」有關,但功能與適用場景完全不同,不可互相替代。
| 項目 | Robots Meta / X-Robots-Tag | robots.txt | rel="canonical" |
|---|---|---|---|
| 位置 | HTML head 或 HTTP header | 網站根目錄 txt 檔 | HTML head 內 |
| 控制顆粒 | 單一頁面/檔案 | 整站/目錄/URL 模式 | 單一頁面 |
| 主要用途 | 是否索引、是否追蹤 | 是否允許爬取 | 指定主要版本網址 |
| 爬蟲是否仍會抓取 | 會(才能讀到指令) | 不會(被 disallow 擋掉) | 會 |
| 是否傳遞權重 | follow 時傳遞 | 不傳遞(無法判斷) | 傳遞到指定的主要版本 |
| 使用情境 | 不索引但保留爬取 | 禁止爬取消耗資源 | 處理重複內容 |
三者選擇邏輯:不想被「索引」→ Robots Meta noindex;不想被「爬取」→ robots.txt disallow;有重複內容要指定主要版本 → canonical。
想深入了解這三種工具,可分別參考 robots.txt(爬取控制)與 Canonical 標記(重複內容擇一收錄)的完整說明,三者搭配才能完整管理索引。
最容易踩雷的衝突情境
最常見的錯誤是:同時在 robots.txt 禁止爬取、又在 HTML 寫 noindex。這樣會造成爬蟲根本進不了頁面,看不到 noindex 標籤,結果頁面反而仍可能被索引(因為其他網站連結指向它,Google 知道網址存在但無法讀到內容)。
noindex 時,絕對不要在 robots.txt 同時封鎖該頁面。應該讓爬蟲能爬到頁面,才能正確讀到 noindex 指令並從索引中移除。
SEO 與 AEO 最佳實務
在 AI 搜尋時代,Robots Meta 指令的設定不只影響傳統 Google 排名,也決定您的內容是否會被 ChatGPT、Perplexity、Google AI Overviews 等 AI 引擎引用。以下是同時兼顧 SEO(搜尋引擎優化)與 AEO(答案引擎優化)的實務建議。
SEO 與 AEO 的核心原則
- 想被搜尋與 AI 引擎收錄的頁面:不要加任何 noindex 標籤,維持預設 index, follow。
- 同時想要傳統 SEO 與 AI 搜尋引用:確保 robots.txt 沒有封鎖,Meta Robots 也沒有 noindex。
- 內容單薄頁面(薄內容/分類頁/標籤頁)可設
noindex, follow,避免被當成低品質頁面拖累站點權重。 - 付費內容、登入後內容、感謝頁、追蹤頁,一律
noindex避免污染索引。 - 大型網站建議建立 SOP,新頁面上線前必須檢查 Robots Meta 設定。
AEO 時代的新考量
以 Google 為例,AI 概覽與 AI Mode 只會引用已編入索引、且能在搜尋結果顯示摘要的頁面,noindex、nosnippet、max-snippet 都會限制您的內容在這些功能中的呈現。至於「不希望被拿去訓練 AI、但仍想被 Google 索引」,要用的不是 meta 標籤,而是 robots.txt:GPTBot、ClaudeBot、Google-Extended 都是 robots.txt 的爬蟲名稱,OpenAI、Anthropic 與 Google 的官方文件都以 robots.txt 作為控制方式:
# 不影響 Google 搜尋的索引與排名,只拒絕內容用於 AI 模型訓練
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Google-Extended
Disallow: /
排程與失效時間管理
針對限時活動、即將下架的頁面,使用 unavailable_after 可以讓 Google 在指定時間自動從索引移除,免去手動處理的麻煩:
<!-- 雙11 促銷活動頁,11/30 後自動從索引移除 -->
<meta name="robots" content="unavailable_after: 2026-11-30T23:59:59+08:00">

<!-- 限時報名頁,報名截止後不再顯示在搜尋結果 -->
<meta name="robots" content="unavailable_after: 2026-06-30T18:00:00+08:00">
常見錯誤與排錯
Robots Meta 指令看似簡單,但因為涉及伺服器、HTML、SEO 多個層面,實務上很容易出錯,且錯誤造成的後果通常很嚴重(整站從搜尋結果消失、流量歸零)。以下是 6 個最常見的錯誤情境:
-
整站誤設 noindex
最災難級的錯誤,通常發生在開發環境的
noindex設定忘記在正式環境移除,導致整站從 Google 索引消失。改善方式:正式上線前用 Screaming Frog 或 Google Search Console 全站掃描,確認沒有任何頁面誤設 noindex。 - robots.txt 與 noindex 衝突 想用 noindex 移除頁面,卻同時在 robots.txt 用 Disallow 擋住爬蟲,結果爬蟲讀不到 noindex,頁面反而留在索引中。改善方式:用 noindex 時務必放行 robots.txt,讓爬蟲能進來讀指令。
-
大小寫或拼字錯誤
雖然 Robots Meta 不分大小寫,但寫成
noidex、no-index、nofollow,(尾巴多逗號)等都可能被忽略。改善方式:統一使用標準小寫格式content="noindex, follow",並用驗證工具檢查。 -
放錯位置
把 Meta Robots Tag 寫在
<body>內、或在<head>內但被 JavaScript 動態移除。改善方式:確保標籤在<head>區塊靜態存在,並用 Google Search Console 的「網址檢查」確認 Google 實際看到的內容。 - 同時使用 Meta 與 X-Robots-Tag 衝突 一個用 index、另一個用 noindex,Google 會採用最嚴格的一個(noindex),導致頁面被移除索引。改善方式:同一頁面擇一使用,並建立檢查機制避免衝突。
-
用 noindex 處理重複內容
重複內容(如 ?sort=、?filter= 的多版本 URL)應該用
canonical指定主要版本來「合併權重」,而不是用 noindex 砍掉副本。改善方式:重複內容用 canonical、低品質薄內容才用 noindex,兩者用途不同;電商的篩選器/排序參數頁可參考 Faceted Navigation,整體 重複內容 的處理原則可另行延伸閱讀。
三步驟排錯 SOP
-
用 Search Console 網址檢查工具
輸入網址後查看「索引涵蓋範圍」與「使用者宣告的標準網址」欄位,可看到 Google 偵測到的 Robots Meta 設定與索引狀態。
若狀態顯示「已排除:noindex 標籤」,代表 Google 確認讀到 noindex,需要檢查是否為預期設定。
-
用 curl 或瀏覽器 DevTools 檢查 HTTP 表頭
執行
curl -I https://example.com/page或在 Chrome F12 → Network → Headers 檢查,確認 X-Robots-Tag 是否如預期出現。若 PDF 應該 noindex 但 X-Robots-Tag 沒出現,代表 .htaccess 或 Nginx 設定有誤。 -
用 Screaming Frog 全站掃描
設定爬蟲掃描整站,在「Directives」分頁可看到每頁的 Meta Robots 設定,快速找出誤設 noindex 的頁面。
SEO 月檢報告必備項目:確認預期被索引的頁面沒有意外被加上 noindex。
結論:Robots Meta 指令是 SEO 技術基礎,不可輕忽
Robots Meta 指令是網站與搜尋引擎溝通的標準語言,雖然語法簡單,但設定錯誤的代價極高,可能讓整站從搜尋結果消失,或讓不該公開的頁面被索引。理解 Meta Robots Tag 與 X-Robots-Tag 的差別、熟悉 10 個常用參數、知道何時該用 robots.txt / canonical 取代,是 SEO 從業者與網站管理員的技術基本功。
新站上線或網站改版前,請用以下五個問題自我檢查:
- 正式環境是否還殘留開發階段的 noindex 設定?
- 不想被索引的頁面,robots.txt 是否誤把它擋掉導致 noindex 無效?
- 感謝頁、後台頁、會員專區是否都加了 noindex, nofollow?
- 內部 PDF、機密文件是否透過 X-Robots-Tag 設定不索引?
- 限時活動頁是否設定 unavailable_after 排程下架?
常見問答 FAQ
Robots Meta 指令與 robots.txt 有什麼差別?
Meta Robots Tag 與 X-Robots-Tag 哪個比較好用?
.htaccess 或 Nginx 設定批次套用整個目錄。實務建議:HTML 頁面用 Meta Robots Tag 即可;非 HTML 檔案、大量檔案批次處理、或無法修改 HTML 原始碼(例如 SaaS 平台、SPA 應用)時,改用 X-Robots-Tag。同一頁面不要同時使用兩者,以免衝突。
使用 noindex 後頁面多久會從 Google 搜尋結果消失?
noindex, follow 與 noindex, nofollow 有什麼差別?
noindex, follow 的頁面,follow 最終可能會被當成 nofollow 處理,因為頁面本身不在索引,follow 的價值會逐漸消失。
AI 搜尋時代,Robots Meta 指令還重要嗎?
GPTBot、ClaudeBot、Google-Extended),而不是寫在 meta 標籤。對品牌型網站、知識型內容,通常建議開放 AI 爬取以爭取曝光;對版權嚴格、需要保護資產的網站,則可選擇性封鎖 AI 爬蟲。Robots Meta 指令的角色從「SEO 技術」升級為「數位資產存取策略」,更不能忽視。
如何檢查網站的 Robots Meta 指令設定是否正確?
curl -I https://example.com 快速查看 HTTP 表頭。建議建立「Robots 設定檢查清單」,新頁面上線、網站改版、季度健檢時各跑一次,避免出現災難級的「整站誤設 noindex」事故。
